撰 文丨星 野
编 辑丨美 圻
过去一个月,AI视频领域最激动人心的讨论热潮,并非围绕Seedance、Minmax、可灵等专业视频模型,而是“越界”闯入的通用大模型。
Claude Opus 5.5 靠代码渲染视频,短短数日内催生出大量科普动画、创意短片和音乐MV,在X等平台涌现出多条爆款,甚至带火了一种新的创作范式:Vibe Video。
GPT-6 Astra则扮演起了“AI导演”,从分镜规划做到白模预演,通过深入 Blender、Unreal Engine、DaVinci Resolve 等专业软件,承担场景搭建、镜头预演、剪辑执行等工作,逐渐开始占据视频生成的上游。
两者走的是截然不同的两条路:一条是代码渲染的程序化创意,一条是空间规划的影视工业化。它们都没有在画质上正面硬刚,却从上游入口和细分场景切入,悄悄改写着AI视频的能力边界。
就在通用大模型从外围跨界切入、悄然改写AI视频能力边界的同时,专业视频模型的布局也在加速推进。字节、MiniMax、快手等头部玩家集体向创作上游渗透,逐步覆盖脚本拆解、分镜调度、成片剪辑的完整生产链路。这种对创作全流程的深度扎根,让它们在这轮跨界冲击之中,具备了更强的不可替代性。
 Opus 5.5带火Vibe Video
代码直接“画”出视频?
9月22日,Anthropic 正式发布 Claude Opus 5.5。官方将发布重心放在编程能力与 Agent 任务执行上,视频能力并不是产品发布的主角。但在随后的开发者测试中,意外的爆点悄然出现:这款模型虽不直接输出像素画面,却能通过编写前端代码,生成完成度极高的动画视频。
这并非全新思路。此前 “SVG 画鹈鹕骑自行车” 一类的纯代码绘图测试早已在社区流传。但 Opus 5.5的代码稳定性与任务规划能力,让这种创作方式从玩具级演示走向了全面落地,相关作品先在X平台集中涌现,随后蔓延至小红书、抖音等国内平台。
有创作者调侃,Opus 5.5发布后的一周,自己的时间线几乎被各类AI代码视频填满。
热潮之中,最具破圈效应的标杆案例来自X平台博主 @anabology。他仅向 Opus 5.5 提供了一段参考提示词、Midjourney 调用权限与一份情绪板,模型便自主启动全流程制作,12小时后便输出了一部电影质感的反乌托邦短片。截至目前,该作品相关帖子的浏览量已突破2000万。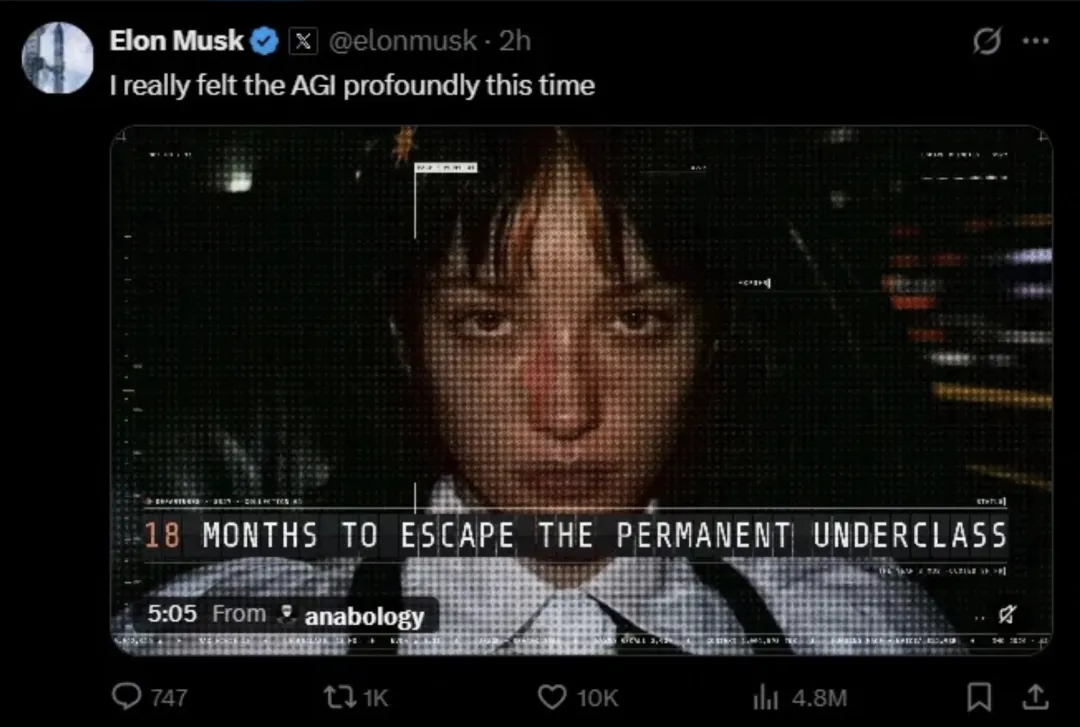 马斯克对这条作品表现出极高关注度,先后多次转发互动,直言 “这一次我真切感受到了AGI的深远影响”。他还对一条“Opus 5.5已达到通用人工智能80%-90%水平” 的观点帖回复 “Accurate”。来自直接竞争对手的公开认可,让 Opus 5.5的视频能力进一步破圈。
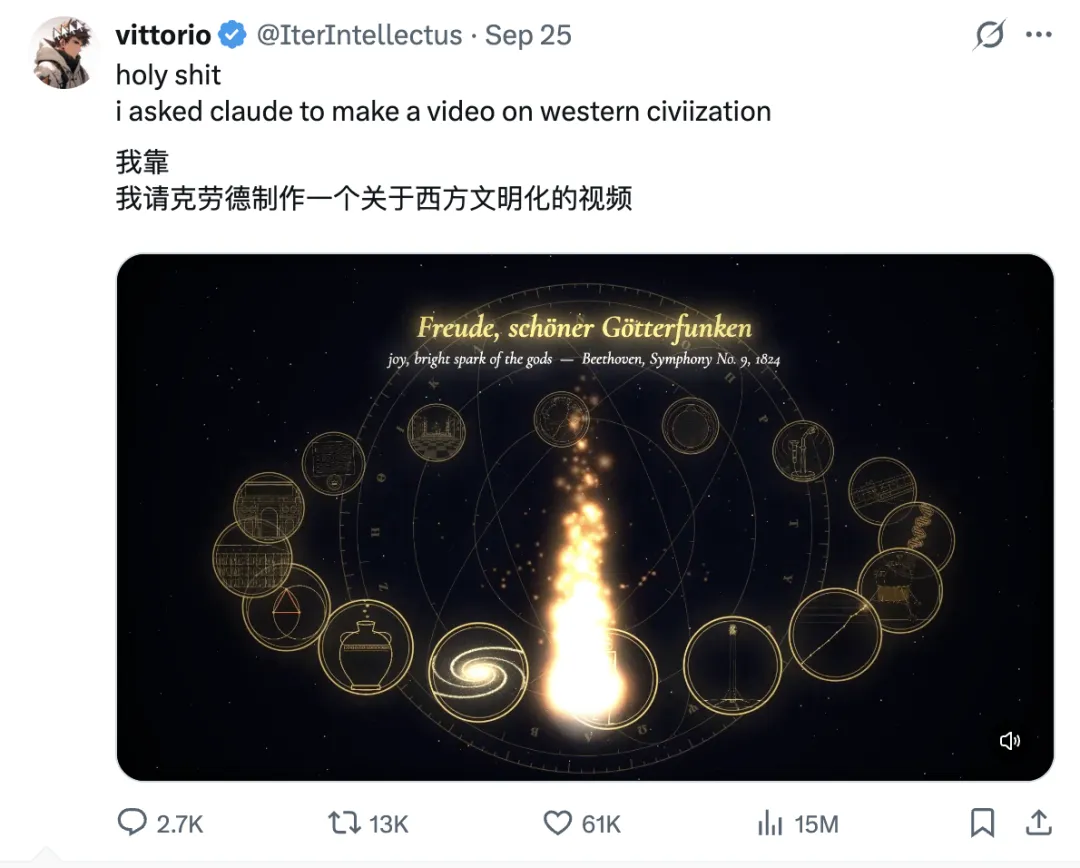
科普短片、产品宣传片等场景也涌现出了大量引爆讨论的案例。博主vittorio仅给出一句创作指令,Opus 5.5 便产出一部2分16秒的西方文明史短片,全片未调用任何专业视频生成模型。视频发布两天播放量破千万。
 有创作者依托Opus 5.5基于Remotion框架编写约7400行前端代码,自动完成全片画面动效与转场节奏编排,搭配开源语音与Python生成的配乐,仅一小时就产出一支三分钟的AI发展史主题视频。
推理初创公司Deedy使用Opus 5.5制作产品发布视频,单条视频生成耗时仅约 1 分钟,API 成本仅约2美元,最终收获32万播放量。Wasmer团队则直接将产品发布公告的文字内容输入Opus 5.5,模型便一次性生成了完整的品牌宣传视频,传播效果超出团队预期。
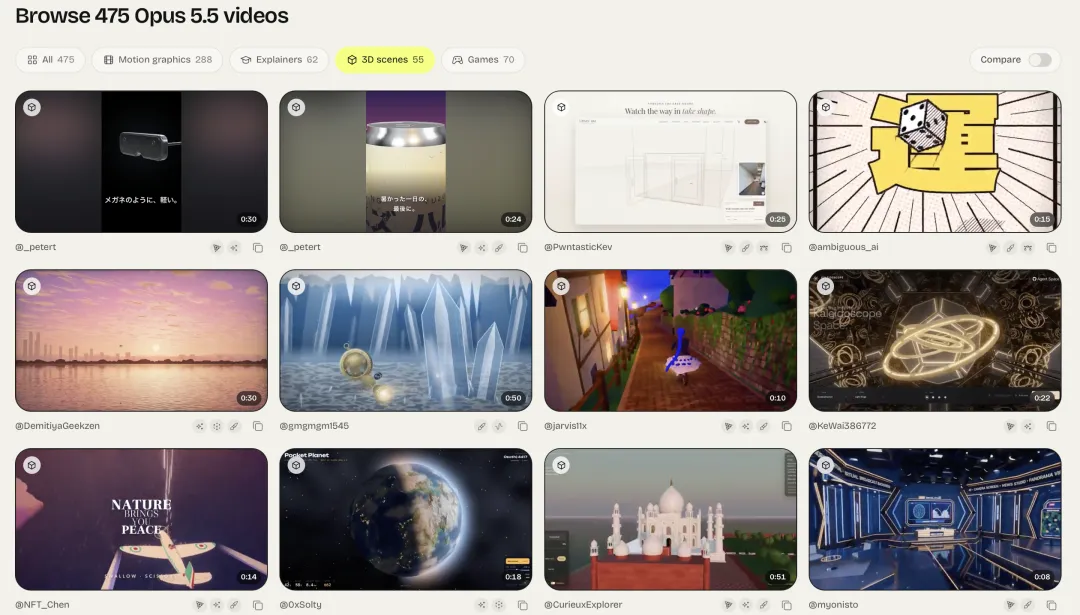 这些案例让“Vibe Video” 迅速成为一种新的创作范式:不依赖专业视频模型,仅凭大模型写代码,就能产出完整视频。GitHub上的案例集合站awesome-opus5-5-videos已收录400多条作品,覆盖动效图形、知识讲解、3D 场景、小游戏等品类,每条都附有创作者公开的原始提示词与代码,相当于把成熟的创作方法论直接开源。国内创作者也纷纷入场,用它制作产品宣传片、科普动画和数据可视化视频。
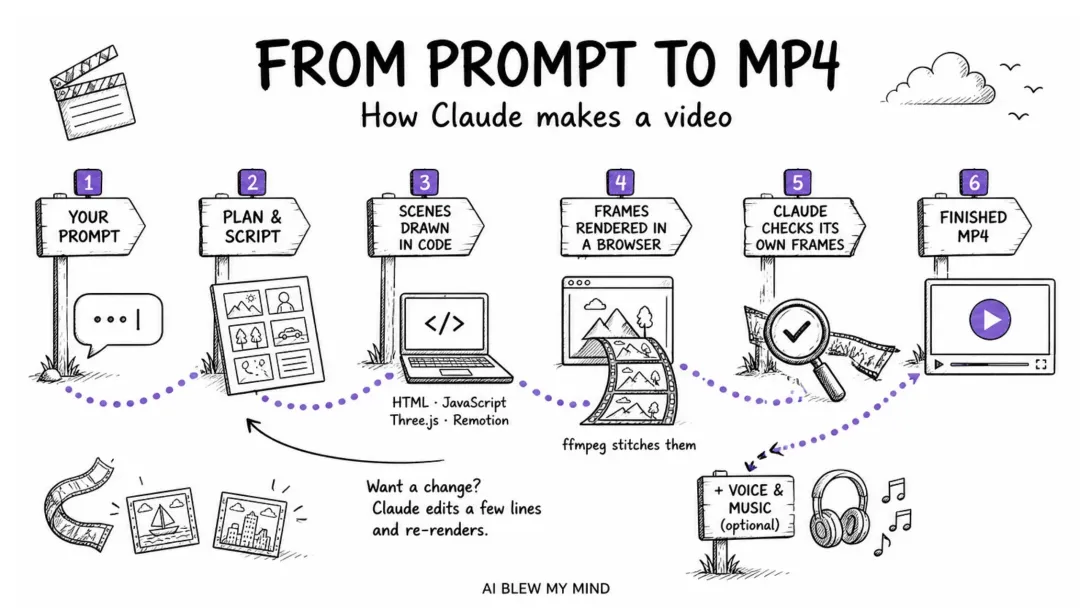 Opus 5.5 的视频生成逻辑,与传统视频生成模型有着本质区别。
传统模型基于海量训练素材一次性生成完整画面,Claude走的是纯代码渲染路线,像专业动效设计师一样逐帧搭建画面——通过编写 SVG、Canvas、Three.js、Remotion等前端代码定义所有视觉元素与运动轨迹,再在无头浏览器中运行并逐帧录制,最终经 FFmpeg编码合成MP4文件,过程中还会自动校验帧画面并修正偏差。
整个流程里,大模型一人分饰四角:担任导演敲定分镜节奏与视觉风格,担任制片拆解任务、调度多段代码并行生成,担任画师以代码逐帧绘制画面元素,担任剪辑完成音画同步与成片输出。
这条路线最大的优势,是极强的可编辑性与极低的迭代成本。传统视频模型一旦结果不满意,往往只能修改提示词、整条重生成;代码生成的视频则只需改动对应镜头的几行代码,参数、运动、风格均可精确控制,画面元素还能分层拆解。
 但Opus 5.5的应用场景边界也十分清晰。它天然擅长程序化、图形化的内容,如文字动效、数据图表、科普动画和抽象3D场景,却很难胜任写实真人画面与复杂的自然物理效果,而后者恰是传统视频模型的核心主场。
这也决定了当前Vibe Video的渗透范围仍集中在轻量化商业内容、知识科普与创意实验赛道,尚未切入影视级写实内容的主流市场。
 GPT-6 Astra抢走导演椅
视频模型将沦为“渲染工”?
如果说Opus 5.5是从代码切入创意视频,GPT-6 Astra则把手伸向了更上游的策划环节,重塑AI视频的生产逻辑。它同样不直接生成最终画面,而是扮演“导演+制片” 的角色:先完成创意规划、空间设计与镜头调度,再交给专业视频模型渲染。
GPT-6 Astra于9月3日正式发布,官方定位为新一代通用智能体模型,核心能力覆盖计算机操作、编程、科学研究等领域,其中对 Blender、Unreal Engine 等三维创作软件的操作能力,成为它切入视频创作的关键支点。
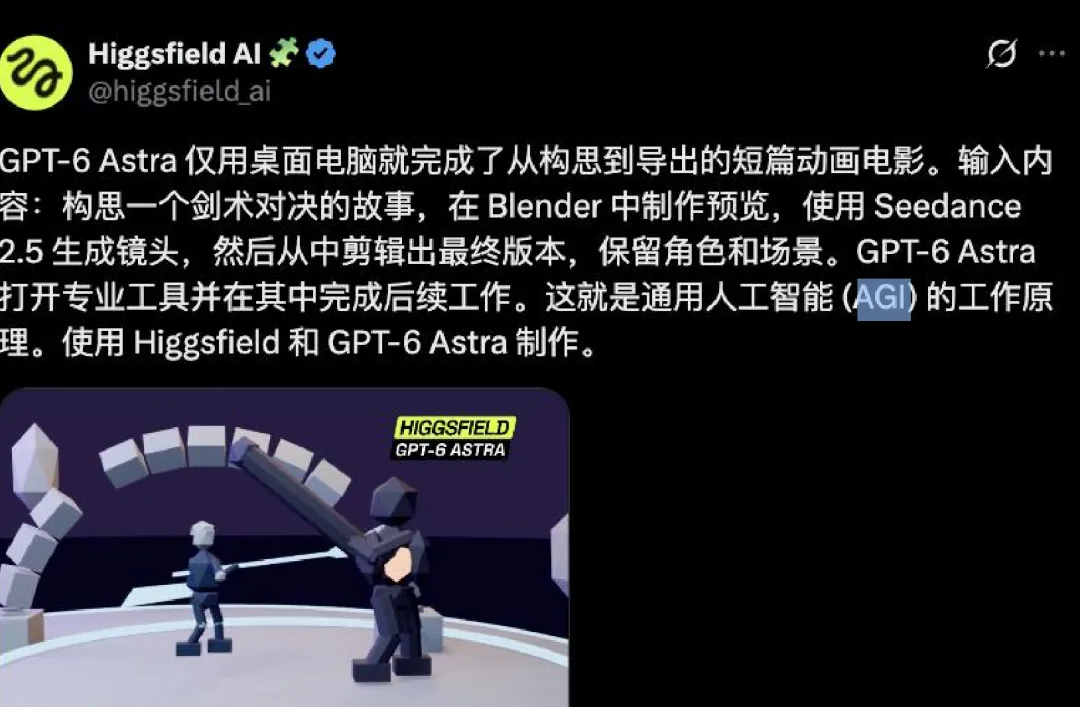 Higgsfield AI公开的一项测试颇具代表性。任务是制作一段连续穿越多个空间的一镜到底动画,Astra没有直接出图,而是先在Blender里用简单几何体搭起白模场景,规划人物走位和整条运镜路线,待空间逻辑与机位运动确认无误,才交给Seedance 2.5渲染成片。
最终成片里,镜头从一个空间穿入下一个空间,人物位置与场景关系始终保持一致,在相当程度上缓解了AI视频长期存在的空间错乱和镜头穿模问题。
Astra的全流程创作能力同样引人注目。海外创作者Nate Herk做过一个实验:只给一句开放式指令,让Astra制作一条关于自身发布的YouTube视频。Astra 自主完成资料调研与脚本撰写,调用工具生成克隆声音旁白,驱动AI数字人出镜,并完成素材剪辑与音乐音效搭配,最终交出可直接发布的成片。
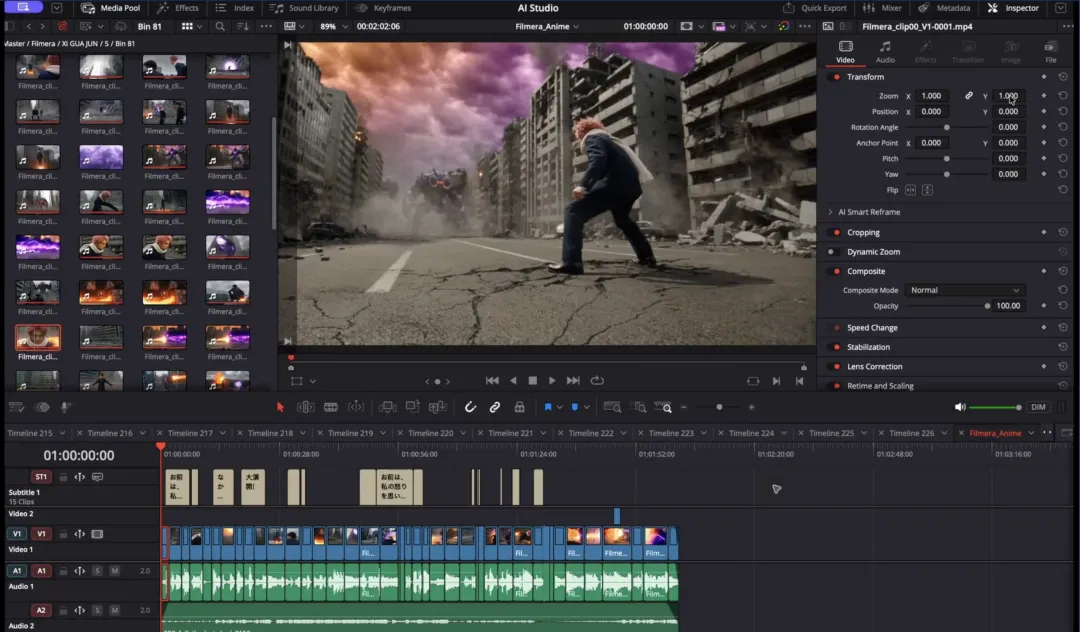 专业剪辑软件的接入,进一步放大了这种能力。9月8日,DaVinci Resolve 21.1上线原生MCP服务器,支持AI助手通过协议直接操作软件。一位拥有20 年经验的剪辑师把75分钟的原始素材交给Astra,它直接操作剪辑软件,输出了包含96个剪辑片段、字幕、调色与音量校准的22分钟粗剪版本,全程无需人工干预。
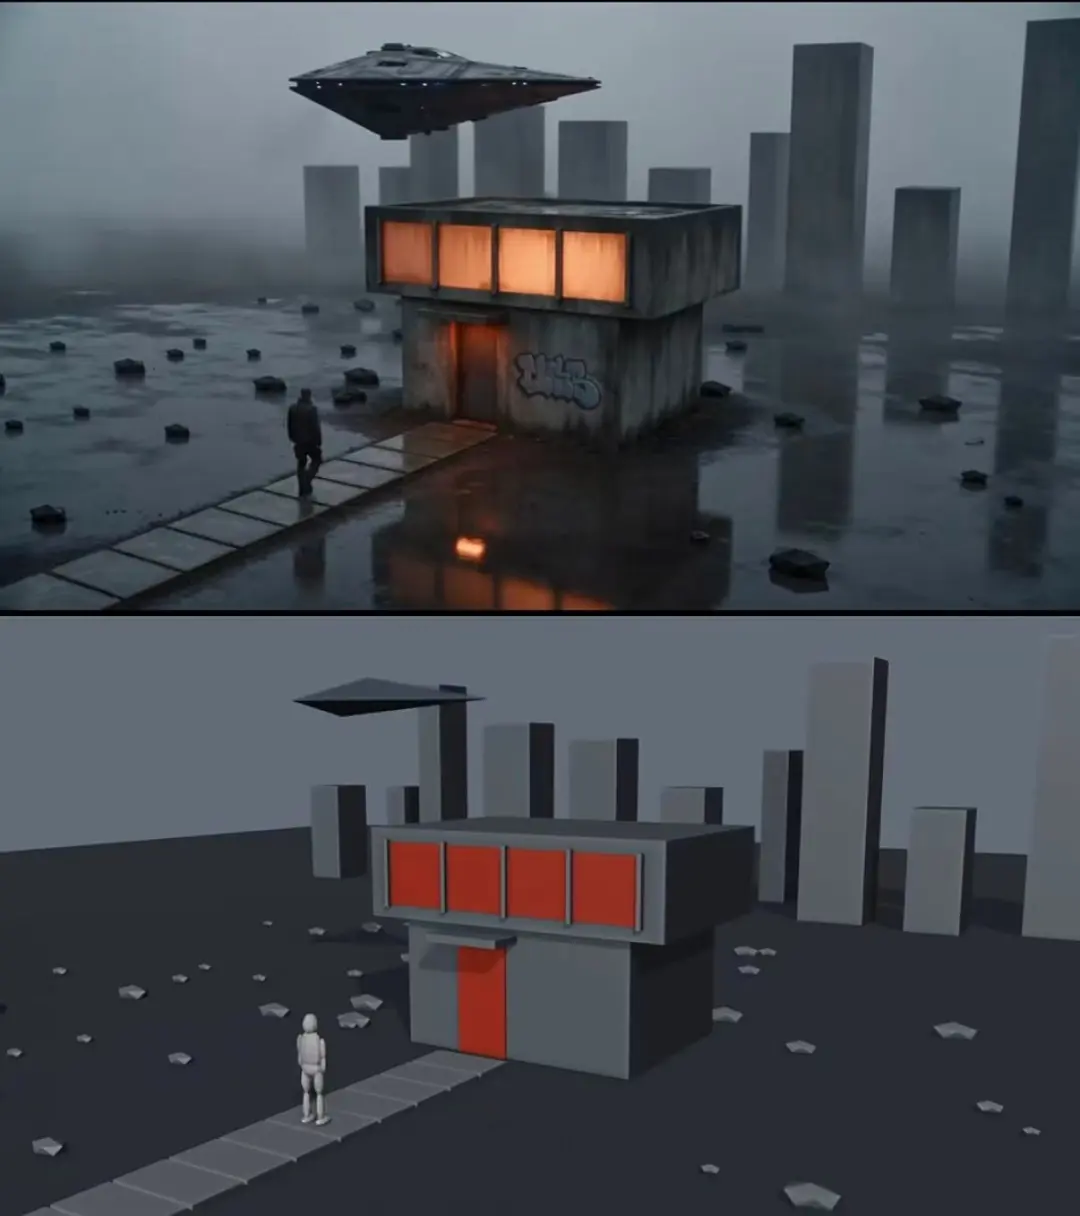 国内创作者也很快摸索出本土化的工作流。有人把完整的仙侠剧本交给Astra拆解分镜、设计镜头,再对接Seedance 2.5生成90秒成片,阵法设计与镜头切换的完成度超出预期;另有创作者总结出一套相对成熟的产品宣传片流程:先由 GPT-6做白模预演,验证镜头可行性,再导出预演视频交给视频模型渲染,最后用剪辑工具合成。整套流程约两小时,成本折合人民币仅150元。
支撑这些表现的,是GPT-6 Astra的世界模型与3D空间理解能力。它能理解多个相连空间的拓扑关系、人物走位的内在逻辑以及摄像机的运动路径,而不只是生成一张张平面画面。
更大的价值在于,创意因此变成了可修改、可复用的资产:空间布局、人物调度与摄像机路线都能留存下来,更换人物、场景、画风甚至故事时,不必从零开始。
至此,通用大模型已走出两条差异化路线,与专业视频模型构成交错竞争的格局。以 Opus 5.5为代表的代码派,长于程序化创意与动效科普,成本低、迭代快,适合轻量化商业内容。
以 GPT-6 Astra为代表的规划派,长于复杂镜头调度与空间叙事,搭配视频模型可产出影视级内容,更接近专业制作流程。二者并非替代关系,完全可以协同:GPT-6 负责分镜规划,视频模型负责写实部分的渲染,拼成一条互补的工作流。
 视频模型集体跑向上游
全链路布局加固护城河
两条跨界路径,正在悄悄重构AI视频行业的利益分配。
一方面,产品宣传片、知识科普、数据可视化等商业与创意内容,开始Claude低成本的代码路线分流。另一方面,GPT开始掌握视频生成分工,将Seedance等视频模型降格下游的渲染工序,长期或将压低其在产业链上的价值。
就在通用大模型从外围搅动赛道之际,Seedance、可灵、MiniMax等专业视频模型厂商也在按自己的节奏加固护城河。各家方向高度一致:向上游创作环节延伸,深度嵌入创作者的完整工作流,用端到端的生产能力取代单点的素材生成能力。
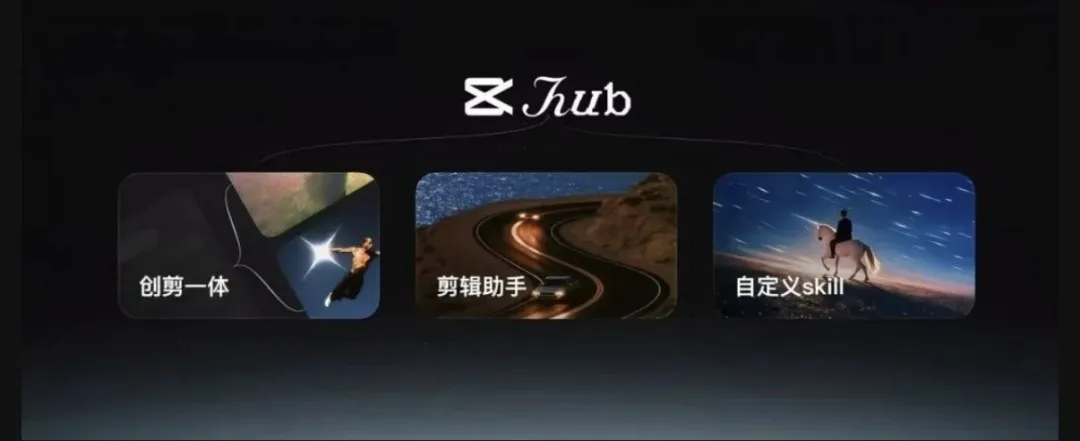 9月20日,剪映在“AI新创作发布会” 上推出一站式创作工作台“剪映Hub” 和智能创作 Agent “剪映助手”。结合此前推出的小云雀Agent、内测的“漫剧创作工具”,字节已搭起“底层模型+垂直场景Agent+通用创作工作台” 的完整生态,用户从产生想法到导出成片,可在字节体系内一站完成。
 其他头部玩家也在加速跟进。7月31日,MiniMax发布新一代多模态视频模型 H3。不到三周后的8月20日,便上线创作Agent工作台MiniMax Design,由主 Agent 拆解需求,调度多智能体并行完成从脚本到成片的全流程。
快手则在9月底亮出双轨布局。一边,可灵AI 4.0官宣10月上线,补齐30秒原生时长、4K HDR、多模态参考等关键参数短板,继续夯实模型层的竞争力;另一边,创作Agent工具ikli的内测消息同步流出,主打从需求理解、脚本编写到镜头生成、配音剪辑的全流程制作。
 从结果看,这一轮全链路升级让专业视频模型的护城河更深了。大模型的长处在于创意发散、代码生成与流程调度,但在核心商业创作场景中,创作者要的不止是把想法落地,还有稳定的画质、标准化的成片质感、可复用的素材资产,以及与既有工作流的无缝衔接,而这些正是专业厂商深耕的领域。
叠加全链路Agent的加持,专业视频模型在短剧、漫剧、品牌广告等核心赛道上,短期内仍有难以替代的价值。
换言之,大模型带来的是新的技术路径与创作思路,拓宽了AI视频的边界,却尚未撼动专业视频模型的基本盘。
恰恰因为看清了上游入口的分量,字节、快手等才加快了全链路布局的步伐:只有深度嵌入创作者的完整工作流,覆盖从创意到交付的每一个环节,才能真正守住用户入口,不被架空为单纯的算力供应商。
通用大模型与专业视频模型的边界正在模糊,未来的胜负手,不在于谁的参数更高,而在于谁能更深地融入真实的创作生产流程,成为创作者离不开的生产工具。
本文来自投稿,不代表增长黑客立场,如若转载,请注明出处:https://www.growthhk.cn/quan/171090.html
 微信扫一扫
 支付宝扫一扫