过去两年,AI行业的热词换了好几轮。先是参数规模,再是Agent,然后是算力。虽然每一场发布会都在讲能力上限,但真正决定这一轮竞赛能跑多远的,常常是PPT里没有的东西:电、芯片、产能。
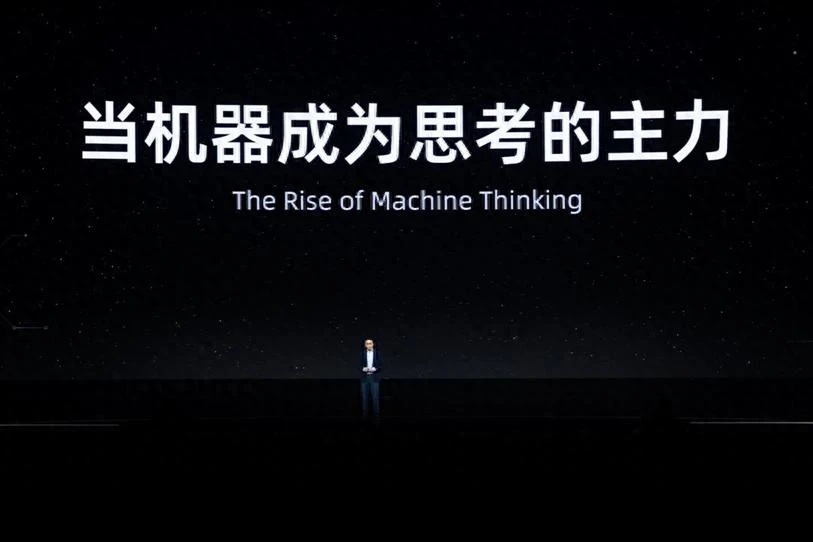
9月22日,在2026杭州云栖大会上,阿里巴巴集团CEO吴泳铭把话题重新拉回了这一层。他没有先讲模型跑分,而是给了两个判断:未来机器供给的思考总量将达到人类的1000倍以上;而机器智能时代的代表性产品,到现在还没有出现。
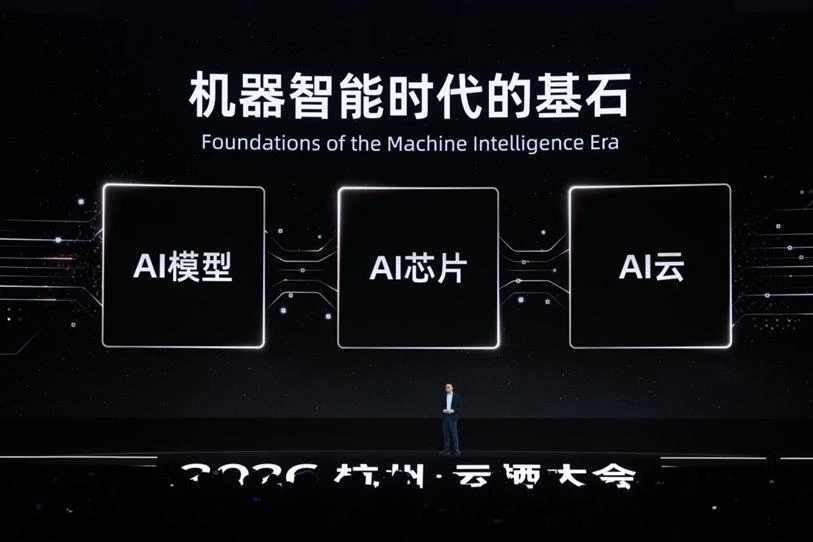
随后给出的三块基石,是AI模型、AI芯片和AI云。“这是我们的长期战略选择”,吴泳铭说。
机器思考的1000倍:需求上限打开,供给成唯一约束
速途网在现场注意到,吴泳铭的第一个判断是从“智能成为规模化的商品”推出来的。他的类比是工业革命:蒸汽机、内燃机把“动力”变成了可以批量供给的商品,到今天机器动力已承担99.9%的物理工作。
推演分成供给和需求两端。供给端,人类顶级思考的数量极其有限。他以罕见病为例,新生儿早衰症全球每年新增病例仅几十例,有记录的患者只有几百人,按现有医药产业的商业逻辑,很少有公司愿意为几百人花十几年、投入巨资研发一款新药。而当AI具备专业研究所需的智力水平后,只要算力足够多、足够便宜,每个细分领域都可以组织上百万个Agent,持续研究、模拟和验证。“顶级思考,将从奢侈品变成可规模化供给的商品”。
需求端的变化更彻底。工业时代,人能消费多少商品取决于人口数量。在吴泳铭的设想里,人只需要提出一个创意和目标,就能调动庞大的智力资源,“每一个超级个体,都可以拥有上万倍的智力杠杆”。思考的消耗量不再与人口数量成正比,而是与机器智能的思考深度和供给规模成正比。在他看来,今天机器思考的总量,大概不到人类的3%,如果未来达到1000倍,那至少还有几万倍的增长空间。
更加值得注意的是第二个判断:机器智能时代的代表性产品还没有出现。他把今天的AI Coding比作1882年的电灯,替代的是古法编程、写报告这类现有工作,而“仅仅替代现有工作,不可能创造一个新的时代”。参照物是电气时代,1882年爱迪生建成珍珠街电站,点亮了附近街区大约400盏电灯;1902年空调出现,而第一台计算机要等到1946年,距离那400盏灯已过去六十多年。
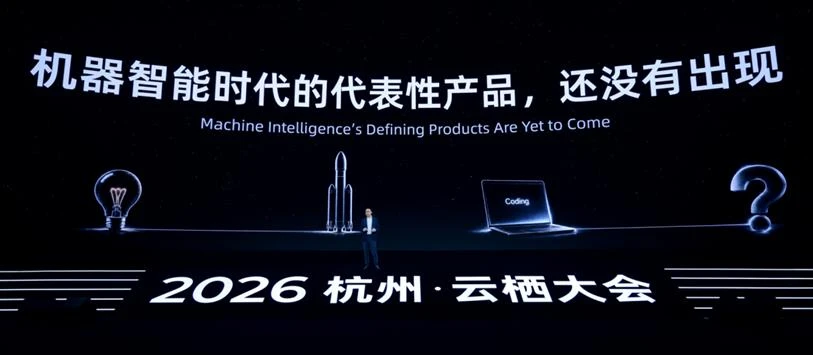
在速途网看来,这两个判断其实是同一个判断的两面:需求侧的上限被打开了,剩下的问题全部落在供给上。所以阿里这次给出的不是一份产品清单,而是一张供给侧图纸。吴泳铭把落脚点说得很直白,无论后来出现多少新发明,第一步都要建足够多的发电站、铺足够广的电网。
三块基石之外,真正的新东西是“反向流动”
按阿里的划分,机器智能时代的三块基石是AI模型、AI芯片和AI云。这三个词不新鲜,但这次披露的进展里,有一部分过去很少被放在一起讲。
模型侧,吴泳铭称通往ASI的技术路径正变得更清晰,核心是递归式自我改进,简称RSI:模型从真实反馈中发现自己的短板,自己设计实验、构建数据、评价结果,循环推动自身进化。Qwen团队正在做这方面的探索,并计划训练5到10万亿参数规模的新模型。多模态与终端侧也在推进,开源的Qwen27B面向本地化部署,移动端发布了Qwen Intelligence。
芯片侧的进展更具体。平头哥已经完成数据中心芯片的全线布局,真武系列做GPU、倚天系列做CPU、磐脉系列做智能网卡,加上ICN互联芯片和镇岳SSD主控。云栖大会上发布的真武V900,单芯片性能是真武M890的3倍,搭载216GB显存,片间互联带宽1200GB/s,原生支持FP8、FP4低精度计算,计划2027年第一季度量产,基于它构建的单一集群可扩展至50万卡。
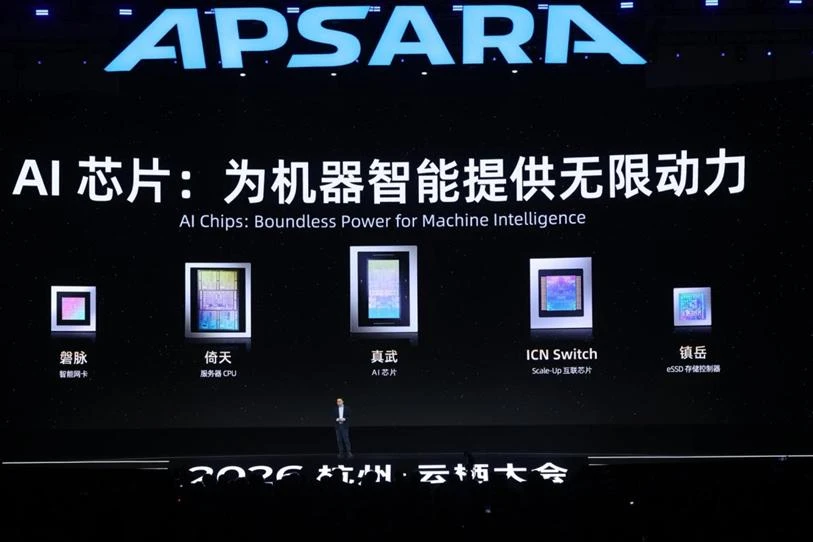
在速途网看来,“全栈自研”这个词过去讲的是纵向一体化,是不必看别人脸色,而阿里这次讲的是另一件事:模型在链条里的位置变了,它从被芯片和云服务的对象,变成了给硬件提效的一方。这个位置变化,比任何一项跑分都更接近“机器智能”这个说法的字面意思。
吴泳铭说的限制条件,比1000倍更重要
速途网在听完吴泳铭的演讲后感受到,这场演讲里信息密度最高的部分其实是他主动说出的约束。吴泳铭提到客户的AI需求非常强劲,阿里云在全力上架AI算力,但同时,行业的中长期需求也远超阿里云的供给能力。当前,AI数据中心相关供应链的全球性紧缺,限制了阿里云算力的增长速度。
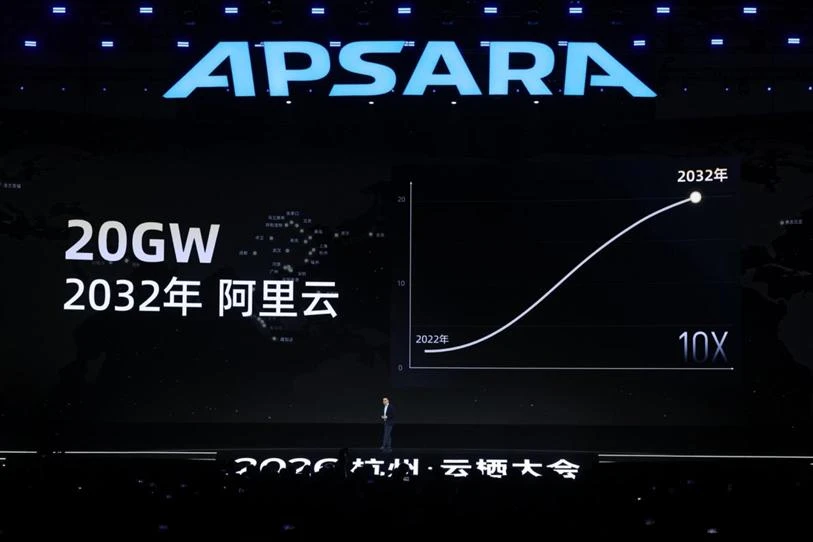
于是有了两个具体动作:2026年第四季度新增服务节点,扩大云上超节点供给;以及一个更远的目标,到2032年阿里云运营的全球数据中心规模超过20GW。
在速途网看来,阿里这一次标出了风险的边界。如果我们把排期表纵向读一遍会发现,真武V900要等到2027年第一季度,倚天750要等到2029年,20GW是2032年的目标。这意味着在相当长一段时间里,“机器思考1000倍”的上限不由模型决定,而由制造、供电和交付能力决定。
另一个值得关注的点是,阿里已开源460余个Qwen模型,累计下载量突破30亿次,衍生模型超过30万个;而商业侧被明确摆上台面的数字,是真武系列截至2026年6月服务超过650家企业客户。开源把使用者的盘子做大,回报则要靠云和芯片来接。国内同时在自研芯片、大模型和云的公司不多,海外头部模型公司的算力多数依赖外部供应商,阿里选的是另一条更重、也更长的路。
写在最后
在速途网看来,吴泳铭这场演讲真正的分量,不在于1000倍这个数字,而在于他把竞争坐标从“谁的模型更强”挪到了“谁的电更便宜”。
电气类比科技行业用过很多次,但这一次类比却开始有可检验的先后关系:发电站和电网必须先建,电器才谈得上普及。阿里把云从“卖算力的生意”重新描述成机器智能时代的电网,意图很清楚,它希望外界按基础设施、而不是按软件来理解这家公司的接下来几年。
当然,重资产的预期在科技行业从来不好讲,因为要先花钱后收钱,中间还要穿过供应链和能源两道关。吴泳铭自己承认供应链紧缺正在拖慢算力增长,等于把这条线的风险提前摊开。而目前这套表述里最扎实的部分,恰恰是那些能被复现的工程数据:模型参与芯片设计让模块面积减少42%,模型自行优化推理框架让单实例吞吐提升96%。如果这类案例能持续出现,全栈自研就从讲给资本市场听的话,变成了可以被第三方核对的产出。
1000倍会不会来,最终由时间回答。但20GW、2027年第一季度、2029年这些日期回答不了别的问题,它们只能回答一件事:阿里愿不愿意为这个判断先付钱。截至目前,它的答案是愿意。
本文来自投稿,不代表增长黑客立场,如若转载,请注明出处:https://www.growthhk.cn/cgo/model/170563.html
 微信扫一扫
 支付宝扫一扫